/ EUR
Wenn du an KI on-premise denkst, beginnt die Wahl des Servers nicht beim Dell- oder HPE-Modell, sondern damit, was du real darauf machen willst. Denn Hardware für Inferenz, Development und das Training großer Modelle sind drei völlig verschiedene Welten. Unten hast du ein Ranking für das Jahr 2026 – aufgeteilt nach Anwendungen. Damit du weißt, was in deinem Fall Sinn ergibt und wo man leicht Budget verbrennt.
Zuerst der Use Case, erst dann die Hardware – sonst verbrennst du Budget
Wenn wir einen Fehler nennen müssten, der sich am häufigsten wiederholt – dann ist es der Kauf eines Servers „auf Vorrat“, ohne festzulegen, was er genau tun soll. Bei KI rächt sich das schneller als in klassischen Umgebungen (SQL, ERP, VM), denn hier muss jede Komponente zusammenspielen.
Es lohnt sich, das in drei Szenarien aufzuteilen:
- Development / R&D – Experimente, Fine-Tuning, Modelltests,
- produktive Inferenz – APIs, Chatbots, Empfehlungssysteme,
- schweres Training – Training von Modellen, CV, LLM, Multimodal.
Jedes davon hat andere Anforderungen und einen anderen investiven Sinn.
Und jetzt so: Wenn du nur Inferenz machst, hat eine Investition in A100 oder L40S oft keine Rechtfertigung – diese Karten werden sich langweilen. Beim Training von Modellen mit 30B+ wiederum wird sich eine GPU der Klasse T4 oder L4 schlicht nicht rechtfertigen, weil VRAM und Bandbreite fehlen.
Wie geht man das an? Zuerst legst du den Workload fest, dann passt du die GPU an, und erst zum Schluss wählst du den Rest (CPU, RAM, Storage). Diese Reihenfolge umzukehren ist der direkte Weg zu einer verfehlten Konfiguration.
Development und Lab – wo ergeben V100 und T4 nach wie vor Sinn?
Für Teamarbeit, Tests und den Aufbau von Pipelines brauchst du nicht sofort Top-Hardware. Und hier verbrennen viele Unternehmen Budget – indem sie die neuesten GPUs kaufen, die die meiste Zeit ungenutzt bleiben.
Sehr gut bewähren sich Konfigurationen vom Typ:
- Dell PowerEdge C4140 mit 4× Tesla V100 32 GB,
- Dell PowerEdge R750xa mit 4× Tesla T4.
Die erste Option bietet 128 GB VRAM in einem Server, was es erlaubt, problemlos mit Modellen 7B–13B, CV oder HPC-Umgebungen zu arbeiten. Das ist bereits ein Niveau, auf dem man reale Experimente machen kann und nicht nur „trockene“ Tests.
Die zweite Konfiguration (T4) ist eine flexiblere Herangehensweise. Weniger VRAM pro Karte, aber die Möglichkeit, viele Prozesse parallel zu starten – was im Development oft wichtiger ist als die reine Leistung einer einzelnen GPU.
Und hier eine wichtige Sache: Plattformen vom Typ R750xa sind für GPU ausgelegt. Du hast die entsprechende Kühlung, Stromversorgung und PCIe-Slots. Das bedeutet, dass:
- du die GPU in Zukunft austauschen kannst (z. B. gegen A40 / L40S),
- du nicht den ganzen Server bei der Weiterentwicklung des Projekts wechseln musst,
- du Stabilität beim 24/7-Betrieb hast, selbst bei höherer Last.
Das ist der Moment, in dem Hardware zu einer Investition wird und nicht zu einer einmaligen Ausgabe.
Produktive KI – wann die L4 die Arbeit besser macht als eine „größere“ GPU
In Produktivumgebungen zählt mehr als rohe Leistung. Hier kommen ins Spiel: Energiekosten, Stabilität, Skalierbarkeit und Vorhersehbarkeit des Betriebs.
Deshalb gewinnen sehr oft Konfigurationen vom Typ:
- Dell PowerEdge R7425 mit 2–3× NVIDIA L4 24 GB,
- Dell PowerEdge R760xa mit 2–3× L4 (neuere Plattform)
Die L4 ist eine für Inferenz und Videoverarbeitung entworfene Karte. Sie hat nicht diesen „Marketing-Wow-Effekt“ wie die A100, aber sie erledigt die Arbeit dort, wo sie muss:
- Bedienung mehrerer Modelle gleichzeitig,
- APIs (Chatbots, Empfehlungen, Suche),
- Bild- und Videoanalyse.
Statt eines einzigen sehr teuren Servers stellst du mehrere Inferenz-Nodes auf. Dadurch:
- skalierst du die Umgebung leichter,
- hast du eine höhere Ausfallsicherheit,
- kontrollierst du die Kosten besser.
Und wichtig – solche Konfigurationen laufen oft pausenlos, also sind Dinge entscheidend, die nicht „im Vordergrund“ stehen:
- redundante Netzteile (1100–2000 W),
- stabile Kühlung für GPU,
- Netzwerk 10/25 GbE, das kein Bottleneck sein wird.
Das sind die Dinge, die entscheiden, ob das System monatelang problemlos läuft oder ständig etwas „abstürzt“.
Schweres Training und LLM – hier beginnen die echten Kosten
Wenn du in das Training größerer Modelle einsteigst, zählt nicht mehr „ob es läuft“, sondern „wie schnell und ob stabil“.
Hier kommen Konfigurationen vom Typ:
- Dell PowerEdge R750xa mit 3× NVIDIA A40 48 GB,
- Dell PowerEdge R750xa mit 3× A100 40 GB,
- Dell PowerEdge R750xa / R760xa mit 3× L40S 48 GB.
In der Praxis bedeutet das: 120–144 GB VRAM in einem Server, die Möglichkeit, Modelle 13B–30B und größer zu trainieren, stabilen Betrieb bei langen Jobs (Tage, nicht Stunden).
Aber hier zeigt sich die Kehrseite der Medaille – die Kosten. Und es geht nicht nur um die GPU.
In solchen Konfigurationen wird zum Standard:
- 2× CPU (Xeon Gold / Platinum oder AMD EPYC),
- 128–512 GB RAM (oft mehr),
- NVMe + RAID (z. B. auf H740P- / H755-Controllern),
- Netzwerk 10/25 GbE, damit die Daten die GPU nicht blockieren.
Und hier begehen viele einen Fehler – sie kaufen eine starke GPU, sparen aber am RAM oder Storage. Das Ergebnis? Die GPU wartet auf Daten.
Wenn du großes Training machst, ist es besser, eine etwas schwächere GPU, aber mehr RAM und schnelleren Storage zu haben als umgekehrt. Denn genau die Daten sind am häufigsten der Bottleneck und nicht die Karte selbst.
Wie überträgt man das Ranking in eine konkrete Wahl?
Wenn du nach all dem einige Optionen im Kopf hast und keinerlei Gewissheit – ist das normal. Die Wahl eines KI-Servers läuft auf einige konkrete Entscheidungen hinaus und nicht auf das Durchsehen von 20 Konfigurationen.
Beantworte dir zuerst drei Fragen:
- ob du hauptsächlich Inferenz (API, Chatbots, Datenanalyse) oder Training von Modellen machst,
- ob du einen starken Server brauchst oder eher mehrere kleinere Nodes,
- wie viele Modelle und Datasets gleichzeitig laufen werden.
Und jetzt die Übertragung auf die Hardware:
- wenn Inferenz dominiert → sind Konfigurationen mit L4 (2–3 GPU) am wirtschaftlichsten,
- wenn du Development / R&D machst → bieten T4 oder V100 im Multi-GPU große Flexibilität ohne hohe Kosten,
- wenn du in Training und größere Modelle (13B+) einsteigst → ziele auf A40 / A100 / L40S und mindestens 128–256 GB RAM.
In der Praxis gehen viele Unternehmen in ein gemischtes Modell: ein Server für Training, ein zweiter für Inferenz. Und das funktioniert meist besser als eine einzige „universelle“ Hardware für alles.
On-Premise-Server für KI. Sieh dir die fertigen Konfigurationen an – ohne Zusammenbau von Grund auf auf hardwaredirect.pl
Wenn du keinen Server von Grund auf zusammenbauen und die Kompatibilität von GPU, Stromversorgung oder Controllern prüfen willst – ist es sinnvoller, mit fertigen KI-Servern von Hardware Direct zu beginnen.
Dort findest du Server, die für konkrete Anwendungen vorbereitet sind – von Inferenz bis Training. In der Praxis bedeutet das, dass:
- RAM, RAID und Storage bereits für KI ausgewählt sind (NVMe / SSD, keine zufälligen Laufwerke),
- du ein konfiguriertes iDRAC / iLO hast, sodass die Fernverwaltung sofort funktioniert,
- der Server vor dem Versand Tests unter GPU-Last durchläuft,
- du Hardware mit redundanter Stromversorgung und bereit für den 24/7-Betrieb bekommst.
Das spart viel Zeit – besonders wenn der Server ein Arbeitswerkzeug sein soll und kein Projekt zum Zusammenbauen und Debuggen.
FAQ
Brauche ich für KI immer mehrere GPUs?
Nein. Für Development und Inferenz reicht oft 1 GPU. Multi-GPU ergibt bei größeren Modellen oder paralleler Arbeit Sinn.
Wie viel VRAM ist zum Start „sicher“?
Für kleinere Modelle reichen 16–24 GB, aber bei der Arbeit mit größeren Modellen beginnt es real bei 40–48 GB pro GPU.
Wie viel RAM sollte ein KI-Server haben?
Mindestens 128 GB, aber bei mehreren GPUs und größeren Datasets besser 256 GB oder mehr anpeilen.
Hat RAID bei KI Bedeutung?
Ja. Am häufigsten setzt man RAID 1 fürs System und RAID 10 für Daten ein, um Leistung mit Sicherheit zu verbinden.
NVMe oder SAS-SSD – was wählen?
Wenn du mit großen Daten arbeitest, bietet NVMe eine deutlich bessere Leistung. SAS-SSD bewährt sich als ergänzender Storage.
Ergibt ein Tower für KI Sinn?
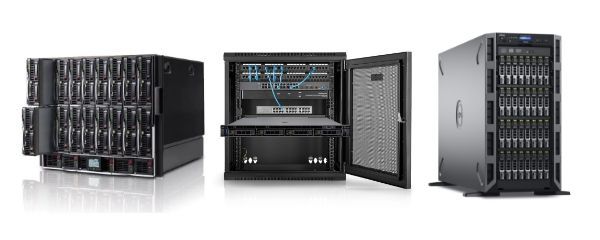
Nur bei sehr grundlegenden Anwendungen (1 GPU). Bei größeren Konfigurationen ist ein Rack praktisch eine Notwendigkeit.
Lohnt es sich, gleich den stärksten Server zu kaufen?
Nein. Besser die Hardware an die aktuellen Bedürfnisse anpassen und sich die Möglichkeit des Ausbaus lassen – sonst verbrennt man leicht Budget.