/ EUR
Wenn du an den Punkt gelangst, an dem du dich fragst „soll ich weiter auf der Workstation drücken oder schon in Richtung Server gehen“ – dann bist du genau an dem Punkt, an dem eine reale KI-Infrastruktur beginnt. Und hier macht die Entscheidung wirklich einen Unterschied, denn sie beeinflusst nicht nur die Leistung, sondern auch, wie du in 3–6 Monaten arbeiten wirst.
GPU bei KI sind keine FPS – sondern VRAM und Skalierung. Hier gehen die meisten Entscheidungen in die falsche Richtung
Wenn du an die Arbeit mit KI denkst und eine Grafikkarte wie Gaming-Benchmarks betrachtest – halte einen Moment inne. In dieser Welt zählt nicht die Anzahl der FPS, sondern völlig andere Parameter. Der wichtigste davon ist VRAM, also der Speicher der Grafikkarte, sowie die Frage, ob du in der Lage bist, parallel auf mehreren GPUs zu arbeiten. Und hier tritt der erste große Unterschied zwischen der Herangehensweise „Workstation“ und „GPU-Server“ auf.
Es kann sein, dass ein 7B-Modell etwa 14–16 GB VRAM braucht, aber wenn du in etwas Größeres einsteigst – z. B. 30B – dann werden daraus plötzlich 40–80 GB VRAM und mehr. Und dann wird eine einzelne Karte, selbst eine sehr starke, zur Einschränkung. Deshalb setzt man in Produktivumgebungen Multi-GPU, NVLink und Server vom Typ Dell PowerEdge R750xa oder R760xa ein, die die Bedienung mehrerer Karten gleichzeitig ohne Bottlenecks erlauben.
Andererseits – und das ist der Moment, in dem viele Budget verbrennen – für einfache Dinge vom Typ Stable Diffusion, lokale LLMs (Ollama, LM Studio) oder Experimente kann eine einzelne Karte RTX 4090 mit 24 GB VRAM mehr leisten als 3 schwächere GPUs in einem Server, wenn du solo arbeitest. Also bedeutet „mehr“ nicht immer „besser“.
Man sollte sich eine Sache merken:
- VRAM = ob das Modell überhaupt startet
- Anzahl der GPUs = wie schnell du das bei größerer Skala machst
Und das ist das Fundament, mit dem du beginnen solltest – nicht mit dem Servermodell oder dem Preis.
Workstation oder GPU-Server? In der Praxis: ein Nutzer vs. das ganze Team – und das ändert alles
Die einfachste und ehrlichste Unterscheidung ist die: Eine Workstation ist Hardware für eine Person, ein Server ist Infrastruktur für ein Team. Und das ändert wirklich alles – von der Arbeitsweise über die Leistung bis zu den Kosten.
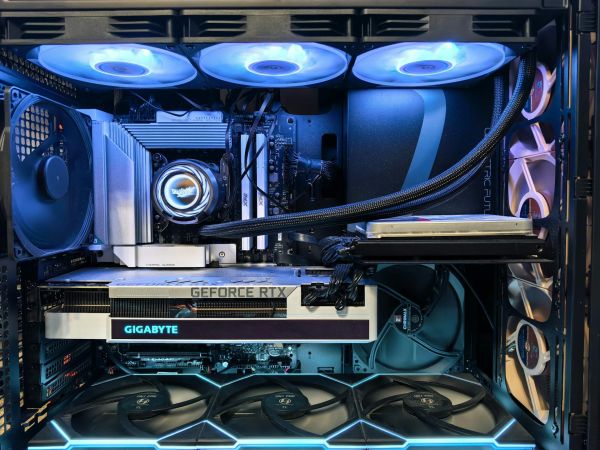
Eine Workstation, selbst eine sehr starke – z. B. mit Threadripper, 128–256 GB RAM und RTX 4090 oder RTX A6000 – funktioniert hervorragend, wenn du lokal arbeitest. Du hast volle Kontrolle, alles geschieht „hier und jetzt“, ohne Netzwerkverzögerungen. Das ist die ideale Umgebung für:
- Modelltests,
- kreative Arbeit (Grafik, Content-Generierung),
- Development.
Aber in dem Moment, in dem ein zweiter Nutzer, eine API oder der Bedarf an kontinuierlichem Betrieb auftritt – beginnen die Schwierigkeiten. Fehlende Redundanz, keine Fernverwaltung auf iDRAC-/iLO-Niveau, begrenzte Skalierbarkeit – all das tritt sehr schnell zutage.
Ein GPU-Server ist eine völlig andere Philosophie. Hier hast du:
- Betrieb 24/7 ohne Unterbrechungen,
- Fernzugriff für viele Nutzer,
- redundante Netzteile und Hot-Swap der Laufwerke,
- volle Verwaltung über iDRAC oder iLO.
Und deshalb beginnen bei Teamprojekten – selbst kleinen – Server vom Typ Dell R7425 mit 3× NVIDIA L4 viel schneller Sinn zu ergeben, als man denkt. Denn es geht nicht nur um die Leistung, sondern um die Stabilität und Verfügbarkeit der Umgebung.
Prototyp, API oder Modelltraining? Beantworte das zuerst, bevor du die Hardware wählst
Der häufigste Fehler? Die Wahl der Hardware, ohne festzulegen, was du eigentlich darauf machen willst. Denn KI ist nicht ein Anwendungsfall – sondern mehrere völlig verschiedene Szenarien.
Wenn du Prototyping, Tests, LoRA, Stable Diffusion oder lokale Modelle machst, ist eine Workstation mit einer starken Karte die vernünftigste Wahl. Sie bietet Geschwindigkeit, keine Verzögerungen und niedrigere Einstiegskosten. Und wichtig – du brauchst keine Serverinfrastruktur, damit das Sinn ergibt.
Aber wenn du etwas mehr baust – z. B.:
- einen Chatbot für Kunden,
- ein Empfehlungssystem im E-Commerce,
- eine API zur Content-Generierung,
dann steigst du in eine Welt ein, in der Betriebskontinuität und die Bedienung vieler Anfragen gleichzeitig zählen. Und hier wird der Server zur natürlichen Wahl. Einige GPUs (z. B. 3× L4 oder A40), schnelles NVMe und ein 10/25-GbE-Netzwerk machen in der Praxis einen enormen Unterschied.
Das anspruchsvollste Szenario ist das Training größerer Modelle. Hier braucht man ohne Multi-GPU und viel VRAM (oft 100 GB+) gar nicht erst anzutreten. Und das ist der Moment, in dem Konfigurationen vom Typ:
- Dell R750xa + 3× A100,
- Dell R760xa + L40S,
aufhören, „Overkill“ zu sein, und schlicht zu einem Arbeitswerkzeug werden.
Deshalb beantworte dir, bevor du in Konfigurationen einsteigst, direkt: ob du etwas für dich selbst baust oder für Nutzer. Denn davon hängen 80 % der Hardware-Entscheidungen ab.
Warum Unternehmen nach einigen Monaten ohnehin von der Workstation auf einen Rack-Server migrieren – und was das für dich bedeutet
Am Anfang funktioniert alles hervorragend. Du hast eine starke Workstation, RTX 4090 oder RTX A6000, die Modelle starten, die Ergebnisse sind schnell. Das Problem beginnt dann, wenn die Anzahl der Aufgaben oder Nutzer wächst. Plötzlich zeigt sich, dass eine Maschine mehrere Dinge auf einmal machen muss – und die Ressourcen zu knapp werden.
In der Praxis sieht es so aus, dass Unternehmen sehr oft mit einer Workstation beginnen und nach einigen Monaten auf einen Rack-Server umziehen, weil sie Stabilität, Fernzugriff und parallele Arbeit brauchen. Das ist keine Theorie – das ist ein reales Schema, das sich in den meisten KI-Implementierungen wiederholt.
Wenn du siehst, dass das Projekt wachsen soll, ist es besser, das früher vorherzusehen, statt eine Migration „auf die Schnelle“ zu machen.
Multi-GPU klingt gut, ergibt aber solo oft keinen Sinn – wann es die Arbeit real beschleunigt
Viele nehmen an, dass mehr Karten = besser. Und hier tritt die klassische Falle auf. Multi-GPU ergibt nur dann Sinn, wenn du einen Workload hast, der das nutzen kann – z. B. Batch-Processing, Training oder eine API, die viele Anfragen bedient.
Wenn du allein arbeitest und einzelne Aufgaben machst, ist oft eine starke Karte (z. B. RTX 4090) schneller als mehrere schwächere GPUs in einem Server. Ohne eine entsprechende Aufteilung der Aufgaben und Optimierung – langweilen sich zusätzliche GPUs schlicht.
Deshalb prüfe, bevor du in Konfigurationen mit 3–4 Karten einsteigst, ob dein Case das überhaupt nutzt. Denn hier verbrennt man sehr leicht Budget.
KI-Kosten ohne Schönfärberei: Workstation günstiger zum Start, Server günstiger bei Skala
Am Anfang spricht alles für die Workstation. 4.600–9.200 EUR vs. 11.500–18.500 EUR für einen Server – der Unterschied ist erheblich. Und tatsächlich ergibt das zum Start Sinn.
Aber wenn du weiter blickst, taucht so etwas wie TCO (Total Cost of Ownership) auf. Der Server wird trotz des höheren Preises bei höherer Last wirtschaftlicher, denn er:
- verwaltet die Energie bei vielen GPUs besser,
- hat eine effizientere Rack-Kühlung,
- bedient mehr Nutzer auf einer Plattform.
In der Praxis bedeutet das, dass ein Server bei Teamarbeit oder langem Modelltraining im Unterhalt um 30–50 % günstiger sein kann.
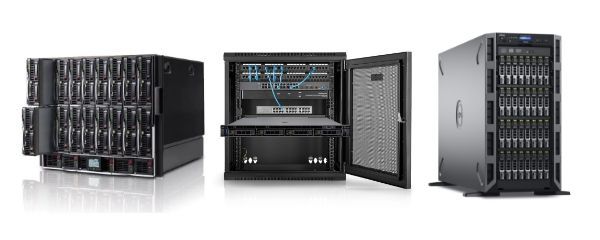
Rack, Tower oder Hybrid – so baut man heute wirklich KI-Umgebungen in Unternehmen
Immer seltener ist die Wahl „entweder–oder“. In der Praxis gewinnt am häufigsten eine gemischte Herangehensweise, also:
- Workstation für Development und Tests,
- GPU-Server für Produktion und Skalierung.
Dadurch kannst du lokal arbeiten, Modelle schnell iterieren und dann die fertige Lösung auf einen Server verlagern, der die Nutzer oder die API bedient.
Diese Herangehensweise ist heute Standard – denn sie bietet Flexibilität und erlaubt es, die Situation zu vermeiden, in der eine einzige Umgebung versucht, alles auf einmal zu machen.
FAQ
Reicht eine Workstation für die Arbeit mit KI?
Ja, wenn du solo arbeitest und Prototypen, Tests oder lokale Modelle machst. Bei größerer Skala werden die Ressourcen schnell knapp.
Ergibt ein GPU-Server für ein kleines Unternehmen Sinn?
Ja, wenn du mehr als einen Nutzer hast oder eine API/Inferenz planst. Dann zählen Stabilität und Verfügbarkeit.
Wie viel VRAM brauche ich zum Start?
Für einfache Modelle – etwa 16–24 GB. Für größere Projekte oder Training – oft 48 GB+ oder Multi-GPU.
Eignet sich die RTX 4090 für KI?
Ja, und sie bewährt sich sehr gut in der lokalen Arbeit. Das Problem tritt erst bei langer Last und 24/7-Betrieb auf.
Wann von der Workstation auf einen Server wechseln?
Wenn du beginnst, mehr als einen Prozess oder Nutzer zu bedienen und Stabilität brauchst, nicht nur Leistung.
Muss der Server neu sein?
Nein. Recertifizierte Server von Dell oder HPE bieten oft ein sehr gutes Preis-Leistungs-Verhältnis und sind sofort nach der Implementierung einsatzbereit.