/ EUR
Wenn du länger als einen Moment KI machst, gelangst du früher oder später an diesen Punkt: Die GPU-Rechnungen beginnen erstaunlich ernst auszusehen. Und dann taucht die Frage auf – weiter in der Cloud fliegen oder einen eigenen Server mit GPU aufstellen? Gleich zerlegen wir das in Konkretes: Wie viel das kostet, wann es sich amortisiert und wo es tatsächlich Sinn ergibt.
Wann sich ein eigener KI-Server zu lohnen beginnt (und zwar schneller, als du denkst)
Bei konstanter Last gewinnt On-Premise überraschend schnell – oft in wenigen Monaten. Wenn die GPU über ~1500 Stunden monatlich arbeitet (also Inferenz-API, Batch-Processing, längere Trainings), kann sich die Investition in 3–7 Monaten amortisieren.
In der Praxis sieht das so aus: Du kaufst z. B. einen Dell R7425 mit 3× NVIDIA L4 oder etwas Stärkeres wie einen R750xa mit A100/L40S und nach einigen Monaten hörst du auf, „pro GPU-Stunde“ zu zahlen. Es bleiben nur Strom und Unterhalt.
Und hier ist der Schlüssel – in der Cloud zahlst du für jede Minute. Selbst wenn das Modell steht, die Pipeline abstürzt oder der Job in der Warteschlange wartet. Lokal gehört die GPU dir und kann 24/7 arbeiten, ohne einen Zähler über dem Kopf.
Wie viel kosten Training und Inferenz in der Cloud wirklich vs. lokal?
Die Cloud sieht zum Start gut aus, weil es keine CAPEX gibt. Das Problem beginnt bei der Skala.
Zum Beispiel:
- AWS mit H100 / A100 sind ~45–185 EUR pro GPU-Stunde,
- bei 1000 Stunden Training werden daraus 46.000–185.000 EUR für ein einziges Projekt.
Hinzu kommen Dinge, über die kaum jemand spricht:
- Datentransfer (Egress sogar einige Euro/GB),
- Storage,
- Job-Retries (z. B. bei Spot-Instances).
Lokal kann sich derselbe Workload auf einem Server vom Typ 3× A100 in mehreren Tausend bis mehreren Zehntausend Euro (mit Strom) abschließen lassen.
Wenn du regelmäßig KI machst und nicht „einmal im Quartal“ – ist der Unterschied nicht x2. Er ist oft x5, x10 oder sogar mehr.
TCO nach 3 Jahren – wo entweicht das Geld wirklich?
Der größte Fehler ist, nur auf die Startkosten zu schauen. Bei KI zählt die TCO (Total Cost of Ownership).
Ein Beispiel aus realen Konfigurationen:
- On-Premise-Server (z. B. R7425 + 3× L4) → ~23.000 EUR über 3 Jahre,
- Cloud bei derselben Last → sogar 670.000–1.840.000 EUR.
Der Unterschied? Sogar 18× zugunsten von On-Premise.
Warum das so ist:
- in der Cloud zahlst du für Compute, Storage, Transfer und den Plattform-Aufschlag,
- lokal ist der größte Kostenfaktor die Hardware + ~230–345 EUR monatlich (Strom + Kühlung).
Im Ergebnis kostet dich nach der Abzahlung des Servers jede weitere GPU-Stunde nur Centbeträge.
Wann die Cloud nach wie vor Sinn ergibt (und man nicht auf einem Server bestehen sollte)?
Die Cloud ergibt dann Sinn, wenn du keine konstante Last hast. Wenn du machst:
- Modelltests,
- Proof of Concept,
- Experimente ab und zu,
dann ergibt der Kauf eines Servers keinen Sinn.
Die Grenze ist recht einfach:
- <300 GPU-Stunden monatlich → die Cloud ist günstiger,
- >1000–1500 Stunden → On-Premise beginnt die Kosten zu zermalmen.
Es lohnt sich auch, an die Flexibilität zu denken – in der Cloud startest du eine H100 für eine Stunde und das war's. Lokal musst du das geplant haben.
Deshalb sind die besten Setups oft ein Mix:
- lokaler Server für Inferenz / konstante Workloads,
- Cloud für Bursts und Tests.
Leistung und Kontrolle – also warum eine eigene GPU anders „die Arbeit erledigt“ als die Cloud?
Auf dem Papier sind eine GPU in der Cloud und eine GPU lokal dasselbe. In der Praxis – nicht ganz. Lokal hast du volle Kontrolle über die Umgebung, den VRAM und die Pipeline. Du kannst genau das einstellen, was du brauchst – ohne Plattform-Einschränkungen.
In der Cloud kommen oft Einschränkungen hinzu:
- VRAM-Limits pro Instanz,
- Throttling bei geteilten Ressourcen,
- keine volle Kontrolle über den Stack,
Bei der Inferenz großer Modelle (z. B. 30B–70B) macht das einen enormen Unterschied. 3× L4 oder 2–3× A100 lokal bieten Stabilität und Vorhersehbarkeit – ohne „Überraschungen“ mitten im Job.
Das Problem, über das kaum jemand spricht – Egress, Latenz und Vendor Lock-in
Die GPU-Kosten sind das eine, aber in der Cloud kommen Dinge hinzu, die zu Beginn nicht offensichtlich sind.
Das erste Thema ist Egress, also das Herausziehen von Daten aus der Cloud. Bei Datasets, Logs, Inferenz-Ergebnissen – kann das konkrete Kosten erzeugen. Das zweite ist die Latenz – wenn die Anwendung lokal läuft und das Modell in der Cloud, beginnen die Verzögerungen.
Und es gibt noch ein drittes Thema: Vendor Lock-in. Du steigst in ein Ökosystem ein (AWS, GCP), baust die Pipeline auf ihre Dienste und dann … kommt man schwer wieder heraus, ohne alles umzubauen.
Auf einem eigenen Server gibt es dieses Problem schlicht nicht.
Wie sieht ein reales KI-Setup on-premise aus (ohne Overkill)?
Entgegen dem Anschein brauchst du nicht sofort einen Cluster für eine Million. In vielen Projekten reicht problemlos:
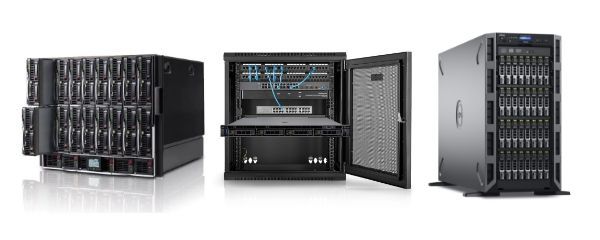
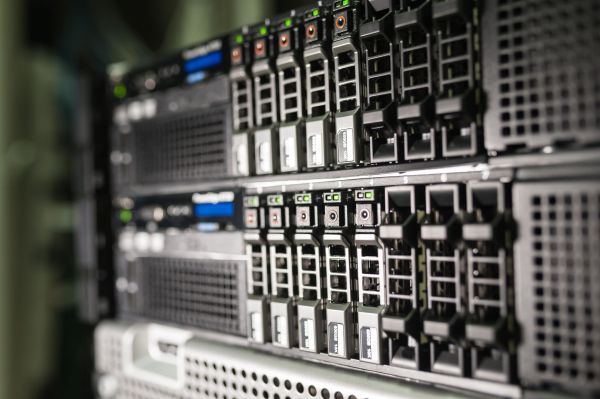
- 1 Rack-Server (z. B. R7425 / R750xa),
- 2–3 GPUs (L4, A100, L40S),
- 128–256 GB RAM + NVMe für Daten.
Und das bedient bereits:
- Inferenz von LLM-Modellen,
- Fine-Tuning,
- Batch-Processing.
Bei Hardware Direct sind solche Konfigurationen üblicherweise bereits vorbereitet – RAID eingerichtet, iDRAC/iLO konfiguriert, Tests gemacht. In der Praxis schließt du an und arbeitest, statt es wochenlang zusammenzubauen. Wenn du geprüfte, fertige KI-Server suchst, sind wir für dich da. Wir helfen, die ideale Konfiguration zu wählen.
FAQ
Nach wie vielen Monaten amortisiert sich ein KI-Server?
Üblicherweise 3–7 Monate, wenn die GPU regelmäßig arbeitet (Training oder Inferenz).
Wie viel kostet der Strom für einen GPU-Server?
Ein typisches KI-Setup sind 2–3 kW, also etwa 160–345 EUR monatlich bei mittlerer Last.
Lösen Spot-Instances in der Cloud das Kostenproblem?
Nur teilweise. Sie sind günstiger, können aber mitten im Training unterbrochen werden – und du verlierst Zeit oder Fortschritt.
Welcher Server ergibt zum Start bei KI Sinn?
Für Inferenz: etwas wie R7425 + 2–3× L4. Für schwerere Dinge: R750xa + A100 / L40S.
Hat die Cloud außer Flexibilität einen Vorteil?
Ja – schneller Start und keine Investition. Aber bei langer Nutzung erzeugt genau dieses Modell die größten Kosten.
Kann man in der Cloud beginnen und auf On-Premise wechseln?
Das ist das häufigste Szenario. Zuerst Tests in der Cloud, dann ein eigener Server, wenn sich der Workload stabilisiert.