/ EUR
Die Anzahl der Server hängt von drei Dingen ab: der zulässigen Ausfallzeit, der Art der Last und den rechtlichen Anforderungen. Kurz gesagt: Ein leistungsstarker Server reicht für ein Unternehmen mit bis zu etwa 25 Nutzern, vorhersehbarer Last und einer akzeptablen, in Stunden gemessenen Ausfallzeit; drei Knoten bieten echte Ausfallsicherheit; zwei sind die schlechteste Wahl – sie verursachen die Kosten eines Clusters, ohne dessen Vorteile zu bieten, sofern kein dritter Quorum-Stimmberechtigter hinzukommt. Im Folgenden zeigen wir konkrete Schwellenwerte, versteckte Lizenzkosten und die tatsächlichen Nachteile jeder Option.
Bevor wir weitergehen, eine Unterscheidung, die das gesamte Thema ordnet. Hier werden drei verschiedene Fragen vermischt: Wie viele physische Server, wie viele virtuelle Maschinen und wie viele Knoten eines HA-Clusters? Das ist nicht dasselbe – ein physischer Server kann ein Dutzend oder mehr virtuelle Maschinen betreiben, bietet aber keine Hochverfügbarkeit, für die mindestens drei Knoten erforderlich sind.
|
Situation |
Empfehlung |
Warum |
|
Bis 25 Nutzer, statische Last, Ausfallzeit von einigen Stunden akzeptabel |
1 Server |
einfach und kostengünstig; Windows Server Essentials deckt bis zu 25 Nutzer ab |
|
Kritische Systeme (ERP, SQL), Ausfallzeit kostet echtes Geld |
3 Knoten (HA) |
Ausfall eines Knotens ohne Stillstand des Unternehmens verkraftbar |
|
HA gewünscht, aber Budget für 2 Maschinen |
2 Knoten + Witness |
ohne dritte Stimme kann der Ausfall eines Knotens das gesamte Cluster stoppen |
|
Von NIS2 betroffene Einrichtung |
Redundanz erforderlich |
Business-Continuity-Plan und angemessenes Redundanzniveau sind verpflichtend |
Scale-up und Scale-out – worin unterscheiden sie sich?
Diese Unterscheidung entscheidet darüber, ob es überhaupt sinnvoll ist, auf eine einzige große Maschine zu setzen. Scale-up (vertikale Skalierung) bedeutet Prozessoren, die über Cache-Kohärenz-Verbindungen (SMP) gekoppelt sind und unter einem gemeinsamen Betriebssystem arbeiten – eine große Maschine, die als Einheit betrachtet wird.
Scale-out (horizontale Skalierung) bedeutet mehrere unabhängige Server, jeweils mit eigenem Betriebssystem und ohne Kohärenzverbindungen. Vorsicht vor einem häufigen Irrtum: Scale-up ist nicht dasselbe wie einfach mehr RAM einzubauen – es ist eine konstruktiv anspruchsvollere Mehrprozessorarchitektur, keine gewöhnliche Erweiterung. Für manche Aufgaben (Scale-out-Workloads) kann eine große Maschine sogar überdimensioniert sein, weil sie eine Speicherhierarchie bereitstellt, die diese Workloads nicht nutzen.
Außerdem sollte man zwei Begriffe trennen, die ständig verwechselt werden: Redundanz ist die Fähigkeit, nach dem Ausfall einer Komponente weiterzuarbeiten, ein Backup dagegen die Möglichkeit, Daten wiederherzustellen. Das eine ersetzt das andere nicht – RAID oder ein zweiter Knoten stellen eine gelöschte Datei nicht wieder her, und ein Backup hält das Unternehmen während eines Ausfalls nicht am Laufen.
Wann reicht ein einzelner Server?
Ein einzelner Server ist eine sinnvolle Wahl, wenn drei Bedingungen gleichzeitig erfüllt sind: Das Unternehmen hat bis zu etwa 25 Nutzer, die Last ist vorhersehbar und einige Stunden Ausfallzeit bringen den Geschäftsbetrieb nicht zum Stillstand. Lizenzseitig passt dazu Windows Server Essentials – es deckt bis zu 10 Kerne und eine virtuelle Maschine ab, ausschließlich auf einem Ein-Prozessor-Server, für Unternehmen mit bis zu 25 Nutzern und 50 Geräten.
Auch der Energieverbrauch spricht deutlich dafür. Ein Server im Leerlauf nimmt mehr als 70 % seiner Spitzenleistung auf, weil nur der Prozessor über wirksame Energiesparmodi verfügt – Arbeitsspeicher, Laufwerke und Netzwerk reduzieren ihre Leistungsaufnahme kaum. Nach einer neueren Betrachtung von Google Cloud (2024) entfallen allein auf die Leerlaufleistung rund 60 % des durchschnittlichen Energieverbrauchs eines Servers.
Der größte Teil der Serverenergie entfällt auf die Betriebsbereitschaft, nicht auf die eigentliche Rechenarbeit. Daten: Methodik von Google Cloud, 2024.
Daraus folgt die wichtigste energetische Erkenntnis: Drei Server mit jeweils 20 % Auslastung verbrauchen deutlich mehr Strom als ein Server mit 60 % Auslastung, obwohl sie dieselbe Arbeit erledigen. Server, die mit 10 % Leistung oder weniger arbeiten, ziehen trotzdem 30–60 % ihres Maximums. Deshalb ist die Aufteilung auf mehrere schwach ausgelastete Maschinen eine der häufigsten Arten, das Energiebudget unnötig zu verbrauchen.
Wann braucht man mindestens zwei – und warum ist zwei die schlechteste Zahl?
Wenn Ausfallzeiten echtes Geld kosten, reicht ein einzelner Server nicht mehr – doch der Sprung „auf zwei“ ist eine Falle. Ein Hochverfügbarkeitscluster arbeitet nach dem Quorum-Prinzip: Es benötigt die Mehrheit der Stimmen. Hat nach einem Ausfall kein Teil des Clusters eine Mehrheit, schalten sich die überlebenden Knoten ab, um die Datenkonsistenz zu schützen.
Bei zwei Knoten hat jeder eine Stimme. Fällt einer aus, entsteht ein 1:1-Gleichstand – keine Seite besitzt die Mehrheit, sodass der Schutzmechanismus das gesamte Cluster stoppen kann. Deshalb:
- drei Knoten sind das Minimum, damit diskless SBD ein Split-Brain-Szenario selbstständig behandeln kann,
- ein Zwei-Knoten-Cluster benötigt eine zusätzliche Stimme (QDevice/QNetd) als Schiedsinstanz,
- die Mindestkonfiguration eines gestreckten vSAN-Clusters besteht aus drei Hosts pro Standort plus einem Witness-Knoten (3+3+1).
Hinzu kommt eine Leistungsreserve, die leicht vergessen wird. VMware empfiehlt, vSphere HA Admission Control auf 50 % CPU und Arbeitsspeicher zu setzen – die Hälfte der gekauften Kapazität wird also als Reserve für die Übernahme der Last nach einem Ausfall vorgehalten. Die eigentliche Antwort auf die Frage im Titel lautet daher: Zwei ist die schlechteste Zahl. Einer ist günstig und einfach, drei bieten echte Ausfallsicherheit, zwei verbinden die Kosten eines Clusters mit dessen Anfälligkeit – es sei denn, ein Witness kommt hinzu.
Was kostet das wirklich – Lizenzen, Strom, Wartungsfenster
Der am häufigsten übersehene und oft entscheidende Kostenfaktor sind die Lizenzen. Windows Server 2025 lizenziert alle physischen Kerne, mit mindestens 8 Lizenzen pro Prozessor und mindestens 16 Core-Lizenzen pro Server – auch bei einem Ein-Prozessor-System. Die Folge für die Strategie „mehrere kleinere“ ist schmerzhaft:
Drei Server mit je 8 Kernen benötigen 48 statt 16 Lizenzen – gleiche Leistung, dreifache Kosten. Daten: Windows Server 2025 Licensing Guide.
Drei Server mit je 8 Kernen benötigen 48 Core-Lizenzen (3 × mindestens 16), während ein einzelner 16-Core-Server 16 Lizenzen benötigt – gleiche Rechenleistung, dreifache Lizenzkosten. Außerdem berechtigt die Standard Edition nur zu zwei Umgebungen (OSE); für jeweils zwei weitere müssen alle Kerne der Maschine erneut lizenziert werden. Aktuelle Preise und Lizenzbedingungen sollten vor dem Kauf geprüft werden.
Der zweite versteckte Kostenfaktor ist das Wartungsfenster. 72 % der Organisationen planen monatlich 2 bis 8 Stunden Ausfallzeit für Patches, Tests und Updates ein. Bei einem einzelnen Server bedeuten diese Stunden einen vollständigen Stillstand des Unternehmens. In einem Cluster können virtuelle Maschinen live migriert werden, ohne den Betrieb zu unterbrechen. Der dritte Kostenfaktor ist Strom – der oben beschriebene Leerlaufeffekt sorgt dafür, dass eine Aufteilung auf mehrere Maschinen die Energiekosten erhöht.
|
Kriterium |
Ein leistungsstarker Server |
Mehrere kleinere |
|
Lizenzkosten |
niedriger (16 Lizenzen) |
höher (16 pro Server) |
|
Energieverbrauch |
niedriger bei guter Auslastung |
höher (Leerlauf × Anzahl der Maschinen) |
|
Ausfallsicherheit |
Single Point of Failure |
höher bei ≥3 Knoten und HA |
|
Wartungsfenster |
Stillstand des gesamten Unternehmens |
Live-Migration ohne Ausfallzeit |
|
Risiko bei Last |
höhere Auslastung = höhere Ausfallrate |
Last verteilt |
Nachteile der Konsolidierung, über die Hersteller selten sprechen
Für eine faire Betrachtung muss auch die andere Seite gezeigt werden. Die Konsolidierung auf einer einzigen Maschine hat reale Nachteile:
- ein einzelner Server ist ein Single Point of Failure und bedeutet ein gemeinsames Wartungsfenster für das gesamte Unternehmen,
- eine höhere Auslastung der konsolidierten Maschine korreliert mit einer höheren Ausfallrate, insbesondere bei Laufwerken und Arbeitsspeicher (Vierjahresstudie, DSN 2017),
- die maximale Leistungsaufnahme eines einzelnen Servers steigt mit jeder Generation – ein dicht bestücktes System kann die vorhandenen Strom- und Kühlkapazitäten im Serverraum überfordern (Analyse von 16 Jahren SPEC Power, 2024).
Ein Komponentenausfall ist dabei keine Ausnahme, sondern ein erwartbares Ereignis. Pro Jahr treten bei rund 9,62 % der Server korrigierbare Speicherfehler auf (Facebook / CMU, 2015), und die tatsächliche Ausfallrate von SSDs kann sogar um 70 % über dem in der Spezifikation angegebenen Wert liegen (Microsoft Research, 2016). Das ist kein Argument gegen Konsolidierung, sondern für Redundanz – unabhängig davon, auf wie vielen Maschinen sie aufgebaut wird.
Die Hardwareklasse ist wichtiger als die Anzahl der Maschinen
Bevor Sie die Infrastruktur „zur Sicherheit“ aufteilen, betrachten Sie belastbare Ausfalldaten. Redundanz aus mehreren günstigen Maschinen hilft nicht, wenn jeder Knoten unzuverlässig ist. Die Unterschiede zwischen den Hardwareklassen sind erheblich:
Jährliche ungeplante Ausfallzeit pro Server nach Hardwareklasse, logarithmische Skala. Daten: ITIC 2024.
No-Name-Server (White Box) verzeichnen 60 Minuten Ausfallzeit pro Jahr, und 42 % davon überschreiten 4 Stunden. Bei Enterprise-Plattformen wie Dell PowerEdge sind es 20 Minuten und 8 % der Systeme mit mehr als 4 Stunden, bei Mission-Critical-Systemen 0 % bis 1,5 %. Hinzu kommt der Lebenszyklus: 78 % der Server, die älter als 4 Jahre sind und stärker belastet werden, verlieren an Zuverlässigkeit; eine Hardware-Erneuerung alle drei Jahre reduzierte bei 95 % der Organisationen die Ausfallzeit. Die Wahl der Serveranzahl ist daher auch eine Entscheidung über den Austauschzyklus, nicht nur über einen einmaligen Kauf. Wie Sie Klasse und Modell auswählen, erklären wir im Leitfaden „Welchen Server wählen?“, die Wahl zwischen neu und rezertifiziert behandeln wir im Beitrag neuer oder rezertifizierter Server.
Wie prüfen Sie, wie viel Leistung Sie wirklich nutzen?
Bevor Sie zusätzliche Hardware kaufen, messen Sie die Auslastung der vorhandenen Systeme. Die Prüfschwellen sind einfach.
- Unter 50 % CPU-Auslastung. Unterauslastung – es gibt Reserven oder zu viele Maschinen.
- 51–85 % Auslastung. Normalbereich – die Hardware arbeitet effizient.
- 86 % und mehr. Überlastung – Zeit für eine Erweiterung oder einen weiteren Knoten.
Als Bezugspunkt gilt, dass die durchschnittliche CPU-Auslastung in Studien oft niedrig ist – etwa 36 % (Messung von 2010, Mechanismus weiterhin aktuell), und in einer Analyse überschritten 80 % der virtuellen Maschinen nicht 60 % der zugewiesenen Ressourcen. Bevor Sie einen weiteren Server kaufen, prüfen Sie, ob der vorhandene nicht überwiegend untätig ist. Konsolidierung funktioniert gerade deshalb, weil Lastspitzen zu unterschiedlichen Zeiten auftreten – mehr als die Hälfte der Server in einer Bank-Workload-Analyse zeigte ein „Heavy-Tail“-Verhalten, sodass eine Maschine Spitzen aufnehmen kann, die nie gleichzeitig auftreten.
Was sagen die Vorschriften – NIS2 und Redundanz
Für manche Unternehmen ist Redundanz keine rein wirtschaftliche Entscheidung mehr. Die Durchführungsverordnung (EU) 2024/2690 zur NIS2-Richtlinie verpflichtet betroffene Einrichtungen zu einem Business-Continuity- und Disaster-Recovery-Plan, zu Backups sowie zu einem angemessenen Maß an Redundanz bei Ressourcen – Einrichtungen, Systemen und Personal. Fällt ein Unternehmen unter NIS2, kann ein einzelner Server ohne Kontinuitätsplan unabhängig von der wirtschaftlichen Rechnung rechtswidrig sein.
Ergänzend nennen auch die EU-Leitlinien EU Code of Conduct on Data Centre Energy Efficiency (JRC, 2025) Virtualisierung und Konsolidierung als Best Practice. Ob NIS2 auf das eigene Unternehmen anwendbar ist, sollte geprüft werden – nicht jedes Unternehmen fällt darunter, für betroffene Unternehmen ist Redundanz jedoch verpflichtend. Ausführlicher behandeln wir dies im Beitrag zur Cybersicherheit gemäß der NIS2-Richtlinie. Der Marktkontext ergänzt das Bild: Trotz der Popularität der Cloud (2025 kauften 55,3 % der Unternehmen in Polen Cloud-Dienste) beziehen nur rund 28 % der Unternehmen in der EU Rechenleistung zum Betrieb eigener Software – die Frage nach eigenen Servern bleibt also relevant.
Wo anfangen?
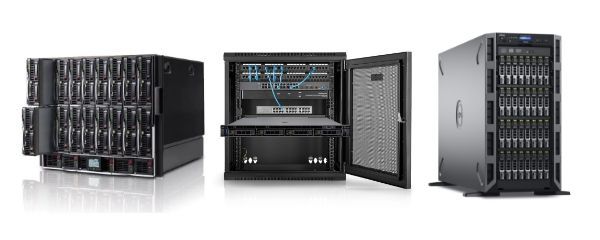
Beginnen Sie mit drei Fragen, nicht mit der Anzahl der Maschinen: Wie viel Ausfallzeit verkraftet das Unternehmen, wie stark schwankt die Last und fällt das Unternehmen unter NIS2? Daraus ergibt sich der Rest – ein Server für ein kleines Unternehmen mit akzeptabler Ausfallzeit, drei Knoten dort, wo Kontinuität zählt, und das Bewusstsein, dass zwei Knoten ohne Witness der schlechteste Kompromiss sind. Schreiben Sie uns, wie viele Nutzer Sie haben, was auf dem Server laufen soll und welche Ausfallzeit zulässig ist. Wir wählen die passende Konfiguration – von einer einzelnen Maschine bis zum HA-Cluster – getestet, einsatzbereit und mit Garantie. Das vollständige Angebot finden Sie in der Kategorie Server – als Tower, Rack und Blade-Systeme.
FAQ
Wie viele Server braucht ein Unternehmen mit 50 Beschäftigten?
In der Regel kann ein leistungsfähiger Server mit Virtualisierung 50 Personen versorgen, sofern die Last vorhersehbar ist und eine in Stunden gemessene Ausfallzeit akzeptabel bleibt. Laufen darauf kritische Systeme (ERP, SQL), sollte für hohe Verfügbarkeit ein Drei-Knoten-Cluster erwogen werden.
Reicht ein Server für ein kleines Unternehmen?
Ja, für etwa 25 Nutzer mit vorhersehbarer Last. Windows Server Essentials deckt Unternehmen mit bis zu 25 Nutzern und 50 Geräten auf einem Ein-Prozessor-Server ab. Die Einschränkung: Ein einzelner Server ist ein Single Point of Failure.
Warum benötigt ein Zwei-Knoten-Cluster eine dritte Stimme?
Ein Cluster arbeitet nach dem Mehrheitsprinzip (Quorum). Bei zwei Knoten führt der Ausfall eines Knotens zu einem 1:1-Gleichstand – keine Seite hat die Mehrheit, daher kann der Schutzmechanismus das gesamte Cluster stoppen. Die dritte Stimme (Knoten oder QDevice-Witness) entscheidet, welcher Knoten weiterarbeiten darf.
Wie viele virtuelle Maschinen passen auf einen physischen Server?
Das hängt von den Ressourcen und der Last der VMs ab, nicht von einem festen Limit. Konsolidierung funktioniert, weil Lastspitzen zu unterschiedlichen Zeiten auftreten. Entscheidend ist eine Reserve – wenn HA geplant ist, empfiehlt VMware 50 % CPU- und Arbeitsspeicherreserve zur Übernahme der Last nach einem Ausfall.
Sind mehrere kleinere Server günstiger als ein großer?
In der Regel nicht. Drei Server mit je 8 Kernen benötigen 48 Windows-Server-Core-Lizenzen statt 16 für eine einzelne 16-Core-Maschine. Hinzu kommt ein höherer Energieverbrauch, weil jeder Server im Leerlauf trotzdem mehr als 70 % seiner Spitzenleistung aufnimmt.
Was passiert, wenn der einzige Server im Unternehmen ausfällt?
Alle darauf laufenden Dienste stehen still – E-Mail, Dateien, ERP, Datenbanken. Ein Backup ermöglicht die Wiederherstellung der Daten, hält das Unternehmen während des Ausfalls aber nicht am Laufen. Betriebskontinuität entsteht erst durch Redundanz, also mindestens drei Knoten in einem HA-Cluster.
Verlangt NIS2 mehr als einen Server?
NIS2 schreibt die Anzahl der Server nicht direkt vor, verlangt von betroffenen Einrichtungen jedoch einen Business-Continuity-Plan und ein angemessenes Maß an Redundanz. In der Praxis bedeutet das für viele Unternehmen, eine Ausfallsicherheit sicherzustellen, die ein einzelner Server nicht bietet. Der Anwendungsbereich sollte geprüft werden.
Literaturverzeichnis
- ITIC – 2024 Global Server Hardware, Server OS Reliability Report – https://www.lenovo.com/content/dam/lenovo/dcg/global/en/products/servers/itic-2024-global-server-hardware-server-os-reliability-report.pdf
- Beloglazov, Buyya et al. – A Taxonomy and Survey of Energy-Efficient Data Centers and Cloud Computing Systems (2010) – https://arxiv.org/pdf/1007.0066
- A Framework for Auditing Data Center Energy Usage and Mitigating Environmental Footprint (2021) – https://arxiv.org/pdf/2102.04446
- Carbon accounting in the Cloud: a methodology for allocating emissions across data center users (Google Cloud, 2024) – https://arxiv.org/pdf/2406.09645
- Uptime Institute – Global Data Center Survey 2024 – https://datacenter.uptimeinstitute.com/rs/711-RIA-145/images/2024.GlobalDataCenterSurvey.Report.pdf
- Natural Resources Defense Council – Data Center Efficiency Assessment (IP:14-08-a, 2014) – https://www.nrdc.org/sites/default/files/data-center-efficiency-assessment-IP.pdf
- Revisiting Memory Errors in Large-Scale Production Data Centers (Facebook / CMU, DSN 2015) – https://users.ece.cmu.edu/~omutlu/pub/memory-errors-at-facebook_dsn15.pdf
- SSD Failures in Datacenters: What? When? and Why? (Microsoft Research, 2016) – https://www.microsoft.com/en-us/research/wp-content/uploads/2016/08/a7-narayanan.pdf
- What Can We Learn from Four Years of Data Center Hardware Failures? (DSN 2017) – https://people.iiis.tsinghua.edu.cn/~weixu/Krvdro9c/dsn17-wang.pdf
- SUSE Linux Enterprise High Availability 16.0 – Installing a Basic Three-Node HA Cluster (2026) – https://documentation.suse.com/sle-ha/16.0/pdf/HA-installing-three-node-cluster_en.pdf
- VMware vSAN Stretched Cluster Guide (2024) – https://www.vmware.com/docs/vsan-stretched-cluster-guide
- High-Availability Clusters: A Taxonomy, Survey, and Future Directions (2021) – https://arxiv.org/pdf/2109.15139
- Windows Server 2025 Licensing Guide (Microsoft, 2025) – https://www.licensingschool.co.uk/wp-content/uploads/2025/02/Licensing_guide_PLT_Windows_Server_2025-February-2025.pdf
- TCO benefits of server virtualization for the SMB (Principled Technologies für Dell, 2012) – https://i.dell.com/sites/csdocuments/Business_smb_sb360_Documents/en/us/wp-virtualization-tco.pdf
- Clearing the Clouds: A Study of Emerging Scale-out Workloads on Modern Hardware (ASPLOS 2012) – https://www.comp.nus.edu.sg/~hebs/course/cs6284/papers/Ferdman-ASPLOS12.pdf
- Virtual Machine Consolidation in the Wild (IBM Research India, Middleware 2014) – https://dl.acm.org/doi/pdf/10.1145/2663165.2663316
- 16 Years of SPEC Power: An Analysis of x86 Energy Efficiency Trends (2024) – https://arxiv.org/pdf/2411.07062
- GUS – Informationsgesellschaft in Polen 2025 – https://stat.gov.pl/files/gfx/portalinformacyjny/pl/defaultaktualnosci/5497/2/15/1/spoleczenstwo_informacyjne_w_polsce_w_2025_r..pdfhttps://stat.gov.pl/files/gfx/portalinformacyjny/pl/defaultaktualnosci/5497/2/15/1/spoleczenstwo_informacyjne_w_polsce_w_2025_r..pdf
- Eurostat – Cloud computing: statistics on the use by enterprises (2026) – https://ec.europa.eu/eurostat/statistics-explained/SEPDF/cache/37043.pdf
- ENISA – Technical Implementation Guidance on Cybersecurity Risk Management Measures, v1.0 (2025) – https://www.enisa.europa.eu/sites/default/files/2025-06/ENISA_Technical_implementation_guidance_on_cybersecurity_risk_management_measures_version_1.0.pdf
- Joint Research Centre (EK) – 2025 Best Practice Guidelines for the EU Code of Conduct on Data Centre Energy Efficiency – https://publications.jrc.ec.europa.eu/repository/handle/JRC141521https://publications.jrc.ec.europa.eu/repository/handle/JRC141521
- Lawrence Berkeley National Laboratory – United States Data Center Energy Usage Report (Aktualisierung 2025) – https://eta-publications.lbl.gov/sites/default/files/2024-12/lbnl-2024-united-states-data-center-energy-usage-report.pdfhttps://eta-publications.lbl.gov/sites/default/files/2024-12/lbnl-2024-united-states-data-center-energy-usage-report.pdf
- Congressional Research Service – Data Centers and Their Energy Consumption: FAQ (R48646, 2025) – https://www.congress.gov/crs_external_products/R/PDF/R48646/R48646.1.pdf